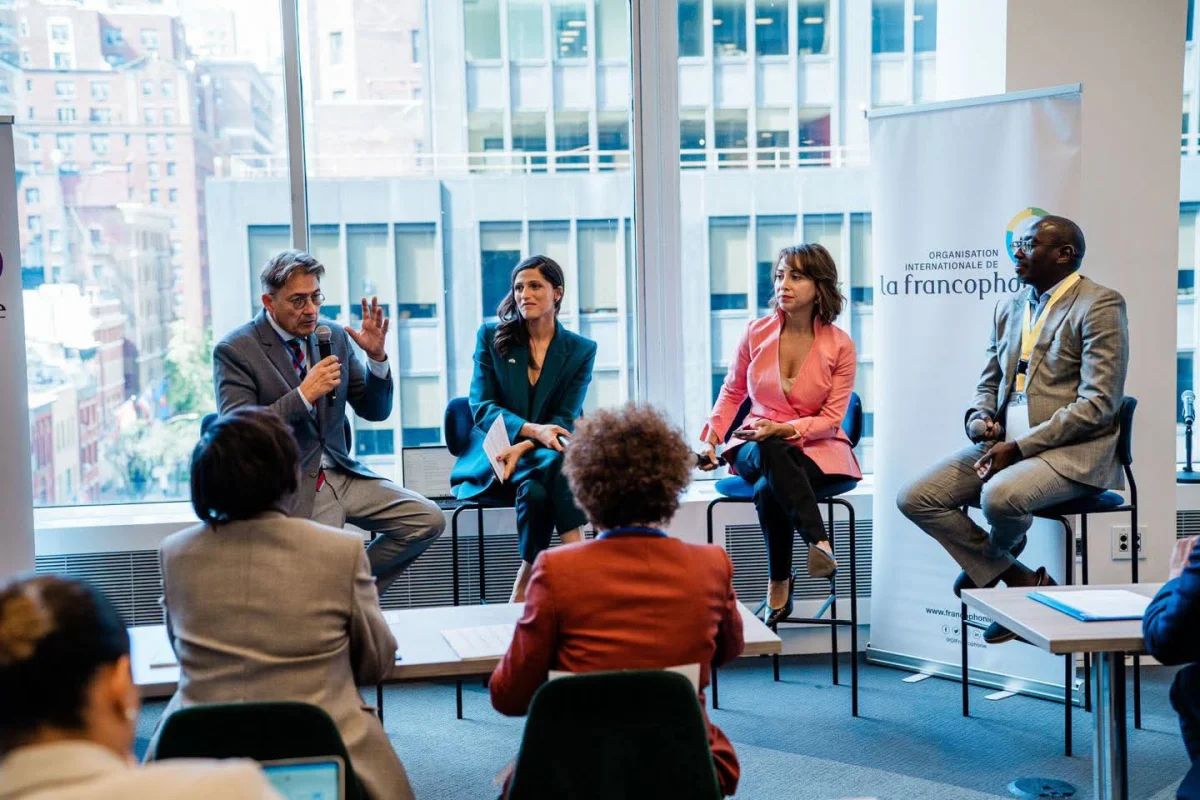
L’intelligence artificielle peut-elle devenir véritablement mondiale si les langues et les cultures sur lesquelles elle s’appuie ne le sont pas ? C’est la question placée au cœur d’un dialogue de haut niveau organisé le 21 septembre 2026 à New York par l’Organisation internationale de la Francophonie (OIF), en marge de la semaine de haut niveau des Nations Unies.
Dans son intervention d’ouverture, la secrétaire générale de la Francophonie, Louise Mushikiwabo, a attiré l’attention sur les déséquilibres linguistiques qui accompagnent actuellement le développement de l’intelligence artificielle.
Une grande partie des systèmes d’IA dépend de volumes considérables de textes, d’images, de sons et d’autres données numériques utilisés pour leur entraînement. Lorsque certaines langues disposent de beaucoup moins de contenus numérisés ou de données de qualité, elles peuvent être moins bien comprises, générées ou prises en compte par les modèles.
Pour l’OIF, cette situation risque de créer une nouvelle forme d’inégalité numérique : les communautés dont les langues sont fortement représentées bénéficieraient de systèmes plus performants, tandis que celles dont les ressources linguistiques sont limitées pourraient rester à l’écart de certains usages de l’IA.
L’enjeu : la question ne concerne pas seulement la place du français face à l’anglais. Elle touche également les nombreuses langues nationales et africaines utilisées quotidiennement dans les pays francophones mais encore peu présentes dans les grands corpus numériques.
Quand la qualité d’une IA dépend des langues présentes dans ses données
Les modèles d’intelligence artificielle apprennent à partir des données qui leur sont fournies. Cette architecture crée un lien direct entre la disponibilité de contenus numériques dans une langue et la capacité d’un système à la traiter correctement.
Une langue disposant d’importantes ressources écrites, de dictionnaires numériques, de bases de données, de contenus médiatiques, scientifiques et administratifs structurés bénéficie généralement d’un environnement beaucoup plus favorable au développement de technologies linguistiques.
À l’inverse, des langues peu numérisées peuvent être confrontées à davantage d’erreurs de traduction, de compréhension, de transcription ou de génération de texte.
Louise Mushikiwabo a ainsi insisté sur la nécessité de ne pas considérer la diversité linguistique comme un sujet secondaire du développement technologique. Pour la Francophonie, la conception des modèles doit également tenir compte des réalités culturelles dans lesquelles les langues sont utilisées.
La culture ne se réduit pas à une traduction
Un autre enjeu mis en avant concerne les contextes culturels. Un modèle peut techniquement traduire une expression sans nécessairement en comprendre les références historiques, sociales ou culturelles.
Pour l’OIF, une intelligence artificielle réellement inclusive doit donc aller au-delà d’une simple multiplication des langues disponibles. Les technologies doivent aussi mieux intégrer les références, usages, expressions et réalités sociales propres aux différentes communautés.
Cette question est particulièrement importante dans un espace francophone extrêmement diversifié, réparti sur plusieurs continents et où le français cohabite avec des centaines de langues nationales.
Dans des pays comme la République démocratique du Congo, par exemple, le français partage l’espace linguistique avec le lingala, le swahili, le tshiluba, le kikongo et de nombreuses autres langues locales. La numérisation et la disponibilité de données de qualité deviennent ainsi essentielles si ces langues doivent bénéficier à terme de services d’IA plus performants.
L’OIF veut passer du constat à l’action
Le dialogue de New York était justement intitulé « Des constats à l’action urgente pour une intelligence artificielle au service de la diversité linguistique et culturelle ».
L’événement a réuni des représentants institutionnels, des scientifiques et des acteurs de l’innovation afin d’identifier des pistes permettant de développer une IA plus inclusive.
Le programme officiel des Nations Unies mentionnait notamment la participation d’Amandeep Singh Gill, secrétaire général adjoint des Nations Unies et envoyé spécial pour les technologies numériques et émergentes, aux côtés de Louise Mushikiwabo lors de l’ouverture.
La table ronde devait également réunir des responsables de l’UNESCO, des chercheurs travaillant sur les modèles ouverts et plusieurs spécialistes de l’intelligence artificielle issus de différents environnements technologiques et universitaires.
Une mobilisation engagée avant New York
La rencontre ne constitue pas une initiative isolée de la Francophonie. Quelques jours auparavant, les 9 et 10 septembre, l’OIF avait déjà réuni à Montréal des chercheurs, acteurs culturels et spécialistes du numérique autour de la découvrabilité des contenus francophones à l’ère de l’intelligence artificielle.
Les échanges avaient notamment porté sur la capacité des œuvres, contenus et productions culturelles francophones à rester visibles dans des environnements numériques où les recommandations sont de plus en plus déterminées par des algorithmes.
Cette problématique rejoint directement celle des modèles d’IA : une langue ou une culture peu présente dans les données risque non seulement d’être moins bien comprise par les systèmes, mais également d’être moins proposée, recommandée et découverte par les utilisateurs.
Les pays francophones appelés à devenir producteurs de données
L’un des messages défendus par Louise Mushikiwabo consiste ainsi à encourager les pays de la Francophonie à ne pas rester de simples utilisateurs de technologies développées ailleurs.
L’enjeu est de participer davantage à la constitution des données, au développement de modèles, à la recherche, aux infrastructures numériques et aux discussions internationales sur la gouvernance de l’intelligence artificielle.
Cette participation suppose notamment de numériser davantage de ressources linguistiques, de développer des corpus fiables, de soutenir la recherche universitaire et d’impliquer les communautés qui parlent effectivement les langues concernées.
La disponibilité des données doit cependant être conciliée avec d’autres exigences : protection des données personnelles, respect des droits d’auteur, consentement des communautés, sécurité numérique et maîtrise de l’utilisation des ressources culturelles collectées.
L’ONU inscrit également les langues dans le débat mondial sur l’IA
La question soulevée par l’OIF s’inscrit dans une discussion plus large aux Nations Unies.
Le Dialogue mondial sur la gouvernance de l’intelligence artificielle, mis en place par l’Assemblée générale en 2025, inclut explicitement parmi ses domaines de travail les implications sociales, économiques, éthiques, culturelles, linguistiques et techniques de l’IA.
Les Nations Unies reconnaissent ainsi que l’écart entre pays ne se limite pas à l’accès aux infrastructures ou aux capacités de calcul. Il concerne également la possibilité de participer aux décisions qui façonneront les technologies utilisées dans les prochaines années.
Les pays disposant de capacités limitées en matière d’IA ont, jusqu’à présent, moins pesé dans ces discussions mondiales, alors même que leurs populations utiliseront elles aussi ces outils.
Pour l’Afrique francophone, un enjeu de souveraineté numérique
Pour les États africains membres de la Francophonie, le sujet
Commentaires